Framework de développement MVP : du prototype au déploiement contrôlé
Réponse courte : un MVP sérieux n’est pas une version cheap du produit final. C’est un système de décision : il transforme une hypothèse métier en prototype, preuve utilisateur, build minimal, tests, déploiement contrôlé, mesure et itération. Le but n’est pas de “sortir vite” à tout prix. Le but est d’apprendre vite sans créer une dette qui bloque la suite.
Beaucoup de MVP échouent pour une raison simple : ils confondent vitesse et précipitation. On code trop tôt, on teste trop tard, on déploie sans garde-fou, puis on appelle “itération” ce qui est en réalité du rattrapage. À l’inverse, les meilleures pratiques de l’industrie — discovery, prototypage, tests utilisateurs, test pyramid, CI/CD, déploiement progressif, observabilité — donnent un cadre plus solide.
Bloc extractible : Le Say Digital Framework de développement MVP suit une chaîne claire : signal métier → cadrage → prototype → preuve → build → tests → CI/CD → déploiement contrôlé → mesure → itération. L’IA accélère la production, mais la qualité vient du cadre : hypothèse, test, preuve, rollback et apprentissage.
1. Le bon point de départ : un signal métier, pas une idée de fonctionnalité
Un MVP ne commence pas par “il nous faut une application”. Il commence par un signal : une perte de temps, une erreur répétée, une opportunité commerciale, une demande client, un process bloqué, une donnée difficile à exploiter, ou un irritant qui coûte cher chaque semaine.
Le premier travail consiste à formuler l’hypothèse métier :
- qui souffre du problème ?
- quel comportement doit changer ?
- quelle décision le MVP doit-il permettre ?
- quel risque doit être testé en premier ?
- quel gain prouver : temps, conversion, erreur évitée, délai, satisfaction, chiffre d’affaires ?
La discipline issue des phases discovery/alpha/beta consiste à ne pas transformer chaque intuition en build. On commence par comprendre le problème, tester les options, puis seulement ensuite stabiliser ce qui mérite d’être livré.
2. Cadrage : écrire le MVP comme une décision à prendre
Un mauvais brief MVP décrit des écrans. Un bon brief décrit une décision. Exemple : “nous devons savoir si les commerciaux utilisent un outil de qualification qui prépare une réponse fiable en moins de 3 minutes”. Cette phrase est plus utile que dix pages de fonctionnalités.
Le cadrage doit tenir en une page :
- problème : le frottement concret à supprimer ;
- utilisateur : qui l’utilise vraiment, pas seulement qui paie ;
- hypothèse : ce que l’on croit vrai ;
- preuve attendue : le signal qui valide ou invalide ;
- périmètre non négociable : ce qu’il faut absolument tester ;
- hors périmètre : ce qui sera volontairement ignoré ;
- risques : usage, faisabilité, données, sécurité, intégration, adoption ;
- kill criteria : ce qui ferait arrêter ou pivoter le projet.
3. Prototype avant build : choisir le niveau de fidélité utile
Le prototype sert à réduire le risque avant d’écrire trop de code. Il peut être très simple : schéma, écran Figma, maquette cliquable, tableur, script, faux bouton, landing page, concierge MVP, workflow manuel derrière une interface, ou mini-démo branchée sur un seul cas réel.
La règle : choisir le prototype le moins coûteux capable de tester le risque principal.
- Risque de compréhension : croquis, parcours, interview, test de wording.
- Risque d’usage : prototype cliquable, test utilisateur, tâche observée.
- Risque de demande : landing page, fake door, inscription, demande de démo.
- Risque opérationnel : concierge MVP ou workflow semi-manuel.
- Risque technique : spike technique isolé, API testée, performance minimale.
Un prototype n’est pas un sous-produit honteux. C’est un instrument de vérité. Il permet de voir où l’utilisateur bloque, ce qu’il comprend, ce qu’il ignore, ce qu’il contourne, et ce qu’il ne ferait jamais même si l’interface est jolie.
4. Test utilisateur : chercher la friction, pas la validation polie
Le test utilisateur d’un MVP n’est pas une présentation commerciale. On ne demande pas “est-ce que vous aimez ?”. On observe une tâche : trouver une information, créer une demande, qualifier un lead, générer un devis, valider un contenu, produire un reporting.
Les pratiques UX classiques montrent qu’un petit nombre d’utilisateurs bien choisis peut déjà révéler beaucoup de problèmes. L’objectif n’est pas la statistique parfaite. L’objectif est d’identifier vite les blocages majeurs, puis de refaire un cycle.
Bonne grille de test :
- l’utilisateur comprend-il la promesse sans explication ?
- réussit-il la tâche principale ?
- où hésite-t-il ?
- quelle information manque ?
- quelle action paraît risquée ou peu claire ?
- quel bénéfice formule-t-il avec ses propres mots ?
- que ferait-il demain si l’outil existait vraiment ?
5. Preuve : décider avant de construire plus
Après le prototype, il faut une décision. Beaucoup de projets restent flous parce qu’ils accumulent des retours sans les convertir en arbitrage. La preuve doit être formulée à l’avance : un nombre d’utilisateurs qui terminent la tâche, une réduction de délai, un taux de clic, une demande qualifiée, une erreur évitée, une intention d’achat, une adoption par un rôle métier.
Trois issues sont saines :
- continuer : le signal est fort et le risque principal baisse ;
- pivoter : le problème existe, mais la solution ou la cible doit changer ;
- arrêter : le signal est faible, le coût ou le risque dépasse la valeur.
Arrêter un MVP faible n’est pas un échec. C’est l’un des résultats les plus rentables : on évite de financer une illusion.
6. Build minimal : construire une tranche verticale, pas une moitié de produit
Quand le build commence, le piège est de construire toutes les fondations sans rien livrer d’utilisable. Un MVP sérieux privilégie une tranche verticale : un parcours complet, sur un cas limité, avec assez d’interface, de logique, de données, de sécurité et de mesure pour être testé dans la vraie vie.
Le périmètre de build doit répondre à trois questions :
- quelle action principale doit fonctionner de bout en bout ?
- quelles intégrations sont nécessaires dès maintenant ?
- quelles limites doit-on assumer publiquement pour ne pas surconstruire ?
L’IA peut accélérer fortement cette étape : variantes d’interface, composants, scripts, tests, documentation, connecteurs, reprise de code. Mais l’IA ne doit pas décider seule de l’architecture, des droits, des données sensibles ou du déploiement. Elle augmente le senior ; elle ne remplace pas le cadre.
7. Tests : protéger la vitesse par une pyramide simple
Un MVP rapide sans tests devient lent dès la première correction. La bonne approche n’est pas de tout tester lourdement. C’est de mettre les bons tests au bon endroit.
- Tests unitaires : règles métier, transformations de données, calculs, permissions simples.
- Tests d’intégration : API, base de données, paiement, email, CRM, automatisations.
- Tests end-to-end ciblés : le parcours critique utilisateur, pas toutes les combinaisons.
- Tests manuels structurés : UX, contenus, cas limites, validations métier.
- Tests sécurité minimum : authentification, autorisations, exposition de données, entrées utilisateur.
La discipline TDD est utile sur les règles critiques : écrire le test avant la logique force à clarifier le comportement attendu. Sur un MVP, on ne cherche pas une couverture théorique parfaite. On cherche à empêcher les régressions qui casseraient la preuve.
8. CI/CD : automatiser le passage de “ça marche chez moi” à “on peut livrer”
La livraison continue ne veut pas dire pousser n’importe quoi en production. Elle veut dire que chaque changement important passe par une chaîne répétable : installation, lint, tests, build, vérifications de sécurité, packaging, environnement de preview, puis décision de déploiement.
Les meilleures équipes réduisent la taille des changements, intègrent souvent, gardent une branche principale saine, utilisent les variables de configuration hors du code, et automatisent ce qui est répétable. Même pour une PME, ces principes évitent une grande partie du chaos.
Checklist CI/CD MVP :
- un dépôt propre et versionné ;
- une commande unique pour installer et lancer ;
- un environnement de preview ou staging ;
- des tests automatiques sur le parcours critique ;
- des secrets hors du code ;
- une base de données migrable ;
- un rollback identifié ;
- un journal des versions livrées.
9. Déploiement contrôlé : livrer progressivement, pas basculer brutalement
Le premier déploiement ne devrait pas être un saut dans le vide. On peut limiter l’exposition : accès interne, client pilote, bêta privée, feature flag, sous-domaine, cohorte réduite, import manuel, lecture seule, ou activation progressive.
Le déploiement contrôlé répond à quatre questions :
- qui a accès au MVP ?
- que peut-il casser ?
- comment sait-on qu’il casse ?
- comment revient-on en arrière ?
Un bon MVP peut être ambitieux dans son apprentissage et prudent dans son exposition. C’est cette combinaison qui permet d’aller vite sans jouer avec la confiance client.
10. Mesure : combiner métriques produit, business et delivery
Mesurer seulement les visites ne suffit pas. Mesurer seulement les tickets techniques ne suffit pas non plus. Un MVP doit relier trois niveaux de métriques.
- Produit : activation, tâche terminée, fréquence d’usage, abandon, temps pour réussir, feedback qualitatif.
- Business : leads qualifiés, temps économisé, coût évité, erreurs réduites, cycle raccourci, revenus influencés.
- Delivery : fréquence de livraison, délai de changement, taux d’échec, temps de restauration, stabilité.
Les métriques DORA sont utiles parce qu’elles rappellent une vérité simple : la capacité à livrer souvent, corriger vite et restaurer rapidement fait partie de la performance produit. Un MVP qui ne peut pas être modifié sans peur n’est pas vraiment agile.
11. Itération : apprendre sans empiler les demandes
L’itération ne consiste pas à ajouter tout ce que les premiers utilisateurs demandent. Elle consiste à choisir la prochaine hypothèse la plus importante. Chaque cycle doit produire une décision : renforcer, simplifier, déplacer, retirer, automatiser, ouvrir à plus d’utilisateurs, ou stopper.
La bonne question après une première version n’est pas “quelles fonctionnalités ajouter ?”. C’est : “qu’avons-nous appris qui change notre décision ?”.
12. Le framework complet Say Digital pour un MVP
- Signal : identifier un irritant métier réel.
- Cadrage : transformer l’idée en hypothèse testable.
- Prototype : tester le risque principal au coût le plus bas.
- Preuve : décider avec un signal observable.
- Build : construire une tranche verticale utilisable.
- Tests : protéger les règles, intégrations et parcours critiques.
- CI/CD : rendre la livraison répétable et contrôlée.
- Déploiement : exposer progressivement avec rollback.
- Mesure : suivre produit, business et delivery.
- Itération : industrialiser seulement ce qui prouve sa valeur.
Checklist opérationnelle avant de lancer un MVP
- Le problème est-il formulé en une phrase claire ?
- Le risque principal est-il identifié : usage, valeur, faisabilité, données, sécurité, distribution ?
- Le prototype choisi est-il le moins coûteux capable de tester ce risque ?
- La preuve attendue est-elle définie avant le test ?
- Le build est-il une tranche verticale plutôt qu’un demi-produit horizontal ?
- Les règles critiques ont-elles des tests ?
- Le déploiement peut-il être limité à un groupe pilote ?
- Existe-t-il un rollback ou une désactivation rapide ?
- Les métriques business et produit sont-elles visibles ?
- La prochaine décision est-elle claire : continuer, pivoter, arrêter ?
FAQ
Quelle est la différence entre prototype et MVP ?
Le prototype teste une hypothèse avec le minimum de production possible. Le MVP est une première version utilisable qui permet d’observer un comportement réel et de prendre une décision produit ou business.
Faut-il toujours coder un MVP ?
Non. Certains MVP commencent par un prototype Figma, un workflow manuel, une landing page, un tableur ou une automatisation simple. On code quand le risque à tester exige un vrai système.
Combien de tests faut-il pour un MVP ?
Assez pour protéger la preuve : règles critiques, intégrations sensibles, parcours principal, permissions et données. Le but n’est pas la couverture maximale, mais la confiance sur ce qui peut casser l’apprentissage.
Où l’IA change-t-elle vraiment le développement MVP ?
Elle accélère la production de variantes, composants, tests, scripts, documentation et prototypes. Mais elle augmente le framework, elle ne le remplace pas : les hypothèses, preuves, risques et validations restent humains.
À lire aussi sur le même cluster
- Développement métier & IA pour PME
- Combien coûte un MVP pour une PME ?
- Diagnostic IA et automatisation : la roadmap 7 jours
- Senior designer ou développeur augmenté IA
Feuilleter le deck Say Digital
Le deck est lisible ci-dessous. Sur mobile, les premières slides sont affichées en aperçu et le bouton ouvre le PDF complet.
Aperçu mobile — glissez pour parcourir les premières slides.
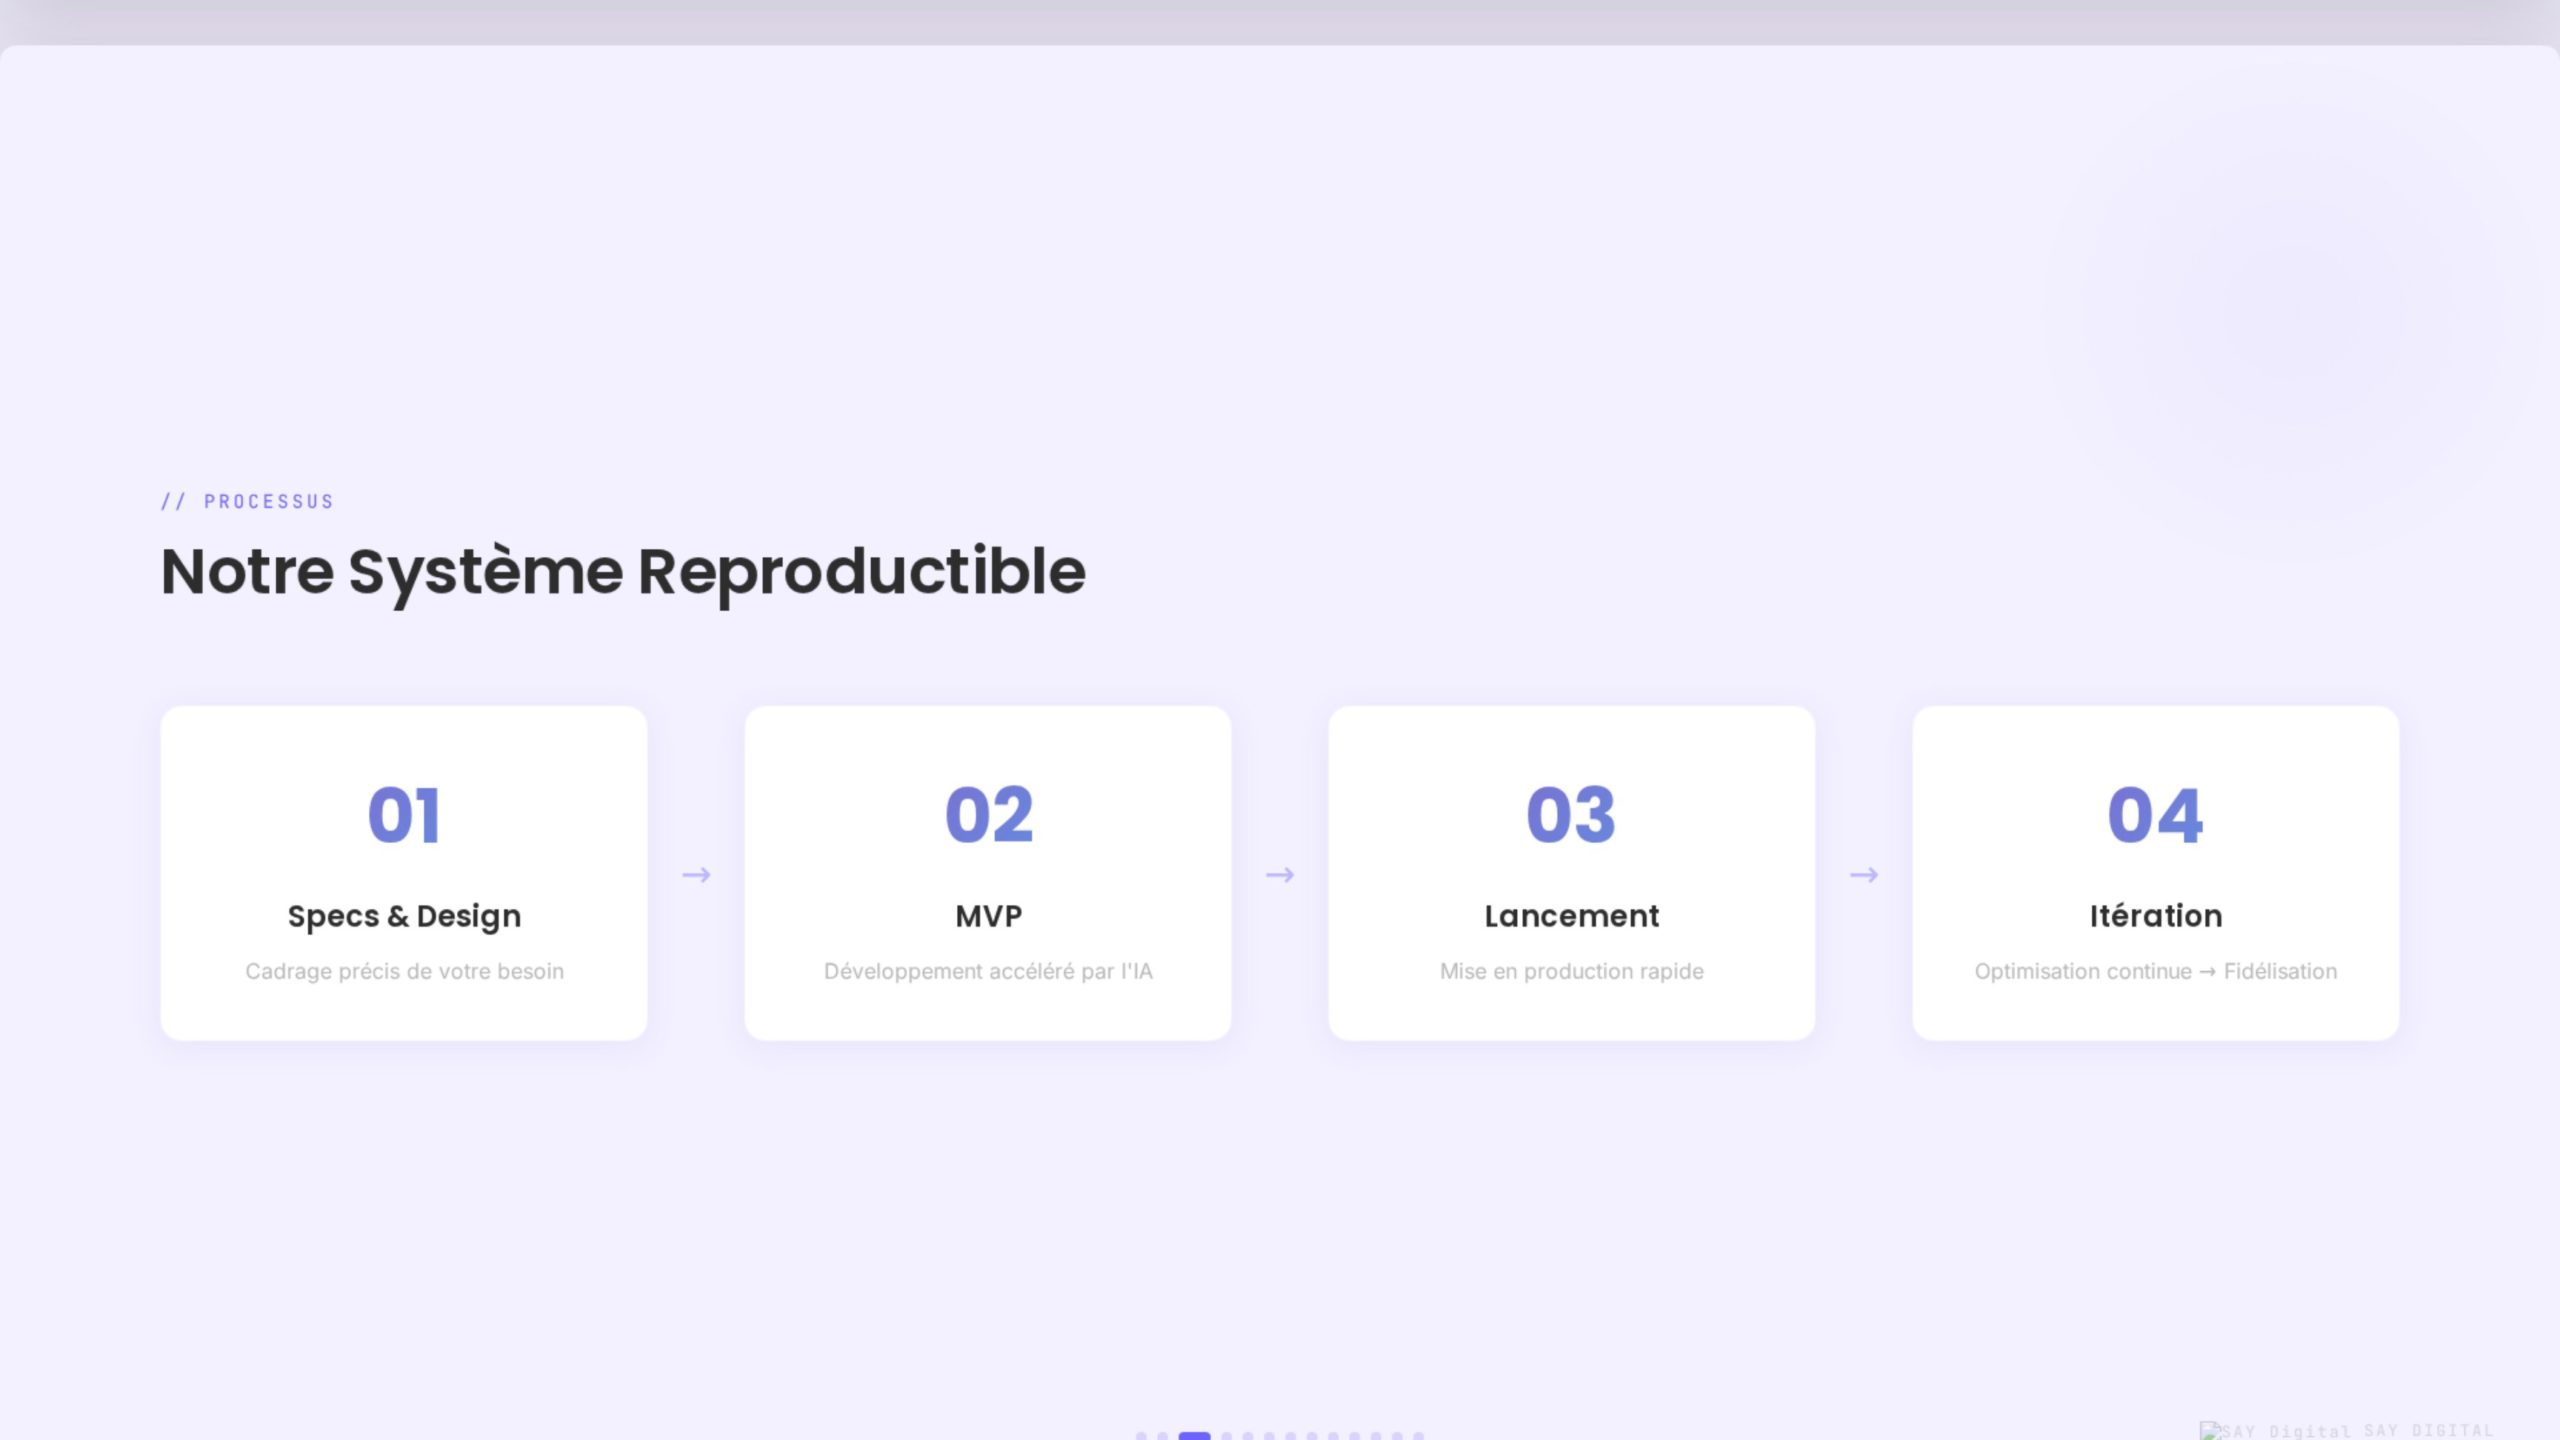
Si la visionneuse ne se charge pas, ouvrez le deck complet.
Besoin de transformer une idée en MVP sérieux ? Say Digital cadre le signal, prototype vite, construit la tranche utile, teste, déploie proprement et mesure la preuve avant d’industrialiser.
Sources et pratiques de référence utilisées
- GOV.UK Service Manual — Discovery phase
- GOV.UK Service Manual — Alpha phase
- GOV.UK Service Manual — Beta phase
- Nielsen Norman Group — tester avec 5 utilisateurs
- DORA — recherche sur les performances de livraison logicielle
- Google Cloud — capacités DevOps
- Martin Fowler — Practical Test Pyramid
- Trunk-Based Development
- The Twelve-Factor App
- OWASP Top 10
- Google SRE — monitoring distributed systems
English version: MVP development framework: from prototype to controlled deployment