
Comment Revolut a repensé son IA pour réduire les coûts et accélérer ses développeurs
Comment Revolut a repensé son IA pour réduire les coûts et accélérer ses développeurs
Chez Revolut, la question n’était plus de savoir si les développeurs allaient utiliser l’IA. Elle était devenue beaucoup plus concrète : comment laisser environ 2 000 ingénieurs travailler avec ces outils sans voir chaque usage supplémentaire alourdir la facture ?
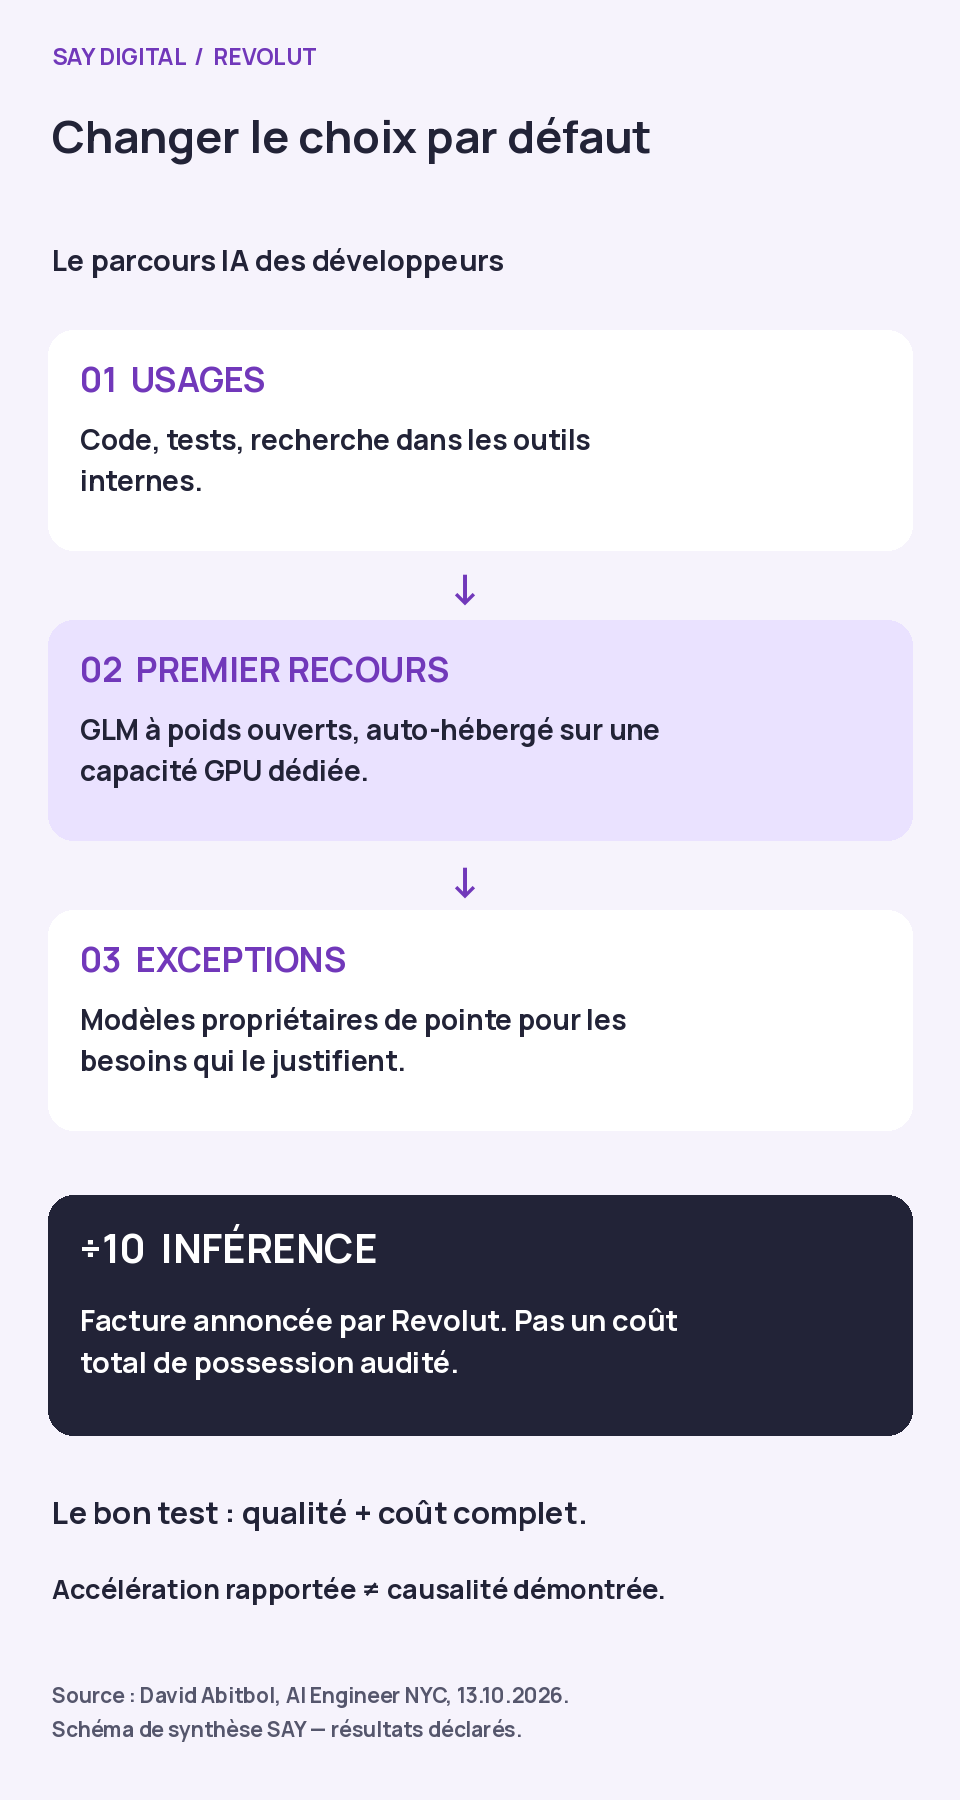
Lors de la conférence AI Engineer NYC du 13 octobre 2026, David Abitbol, responsable des opérations IA de Revolut, a décrit le changement retenu : faire des modèles GLM à poids ouverts, auto-hébergés sur une infrastructure GPU dédiée, le choix par défaut. Les modèles propriétaires restent disponibles pour les exceptions. Revolut annonce une facture d’inférence ramenée à un dixième et décrit une accélération du travail de développement. Voici le mécanisme derrière ces résultats, et ce qu’ils permettent réellement de conclure.
Pas le temps de lire ? L’essentiel en vidéo.
Au départ, des budgets qui freinaient les usages
David Abitbol raconte une première phase d’adoption avec des plafonds stricts. Certains ingénieurs dépensaient, selon lui, 1 000 dollars par mois, voire 10 000 dollars. Ce sont des situations individuelles citées dans la présentation, pas une dépense moyenne à multiplier par les effectifs.
Un plafond protège un budget. Il modifie aussi la manière de travailler : si les requêtes sont comptées, un ingénieur peut réserver l’IA à un problème de code difficile et renoncer à l’utiliser pour retrouver une information ou comprendre un dossier. Revolut voulait rendre ces usages ordinaires moins coûteux, plutôt que simplement distribuer davantage de crédits.
L’équipe s’est donc tournée vers l’auto-hébergement de modèles à poids ouverts au printemps 2026. La présentation mentionne GLM 5.1 pour cette étape, puis GLM 5.3 pour l’infrastructure décrite en octobre. Il ne s’agit pas seulement de changer le nom du modèle dans l’outil : Revolut reprend la responsabilité de faire fonctionner le service d’inférence, c’est-à-dire l’exécution du modèle lorsqu’une requête arrive.
Le changement clé : inverser le choix par défaut
Revolut n’a pas annoncé avoir supprimé les outils propriétaires. David Abitbol explique que Codex, Claude Code et les autres solutions de pointe gardent leur intérêt, mais deviennent l’exception. Les modèles auto-hébergés prennent la place de premier recours.
Ce choix change l’économie de l’usage. Dans un service facturé à la consommation, davantage de requêtes signifie généralement davantage de dépenses. Une capacité GPU dédiée permet de répartir un coût d’infrastructure sur les usages servis, tant que cette capacité suffit. Elle n’est pas illimitée : il faut l’utiliser assez pour qu’elle soit intéressante, et l’augmenter si la demande dépasse ce qu’elle peut absorber.
La qualité reste donc une condition de l’arbitrage. Une requête moins chère qui oblige l’ingénieur à recommencer trois fois ou à corriger davantage de code peut perdre son avantage. Garder des modèles propriétaires pour certains besoins permet de ne pas imposer un compromis unique à toutes les tâches.
Un coût d’inférence divisé par dix, pas une facture informatique complète
Dans sa présentation, David Abitbol avance un coût moyen combiné de 0,30 dollar par million de tokens, ces unités de texte traitées par le modèle, et une facture d’inférence ramenée à un dixième. Ce sont les chiffres déclarés par Revolut dans ce retour d’expérience. Ils ne constituent pas un coût total de possession audité.
La distinction compte pour une direction technique. Au coût de calcul s’ajoutent notamment le temps d’exploitation, la supervision, les mises à jour, les incidents et les évaluations de qualité. Sans périmètre comptable détaillé, on ne peut pas affirmer que l’ensemble des dépenses IA de Revolut a diminué de 90 %.
L’échelle explique aussi le choix. Pour servir environ 2 000 ingénieurs avec GLM 5.3, l’intervenant annonce un besoin d’environ 56 GPU B200. Ce chiffre décrit son architecture ; ce n’est pas une configuration à recommander à une PME. L’auto-hébergement ne précise, à lui seul, ni la propriété des serveurs ni leur localisation géographique.
Accélérer le développement ne veut pas seulement dire écrire plus vite
Le passage le plus intéressant du témoignage concerne peut-être le travail autour du code. David Abitbol cite la recherche d’informations dans les messages, Jira ou Confluence. Avec un accès moins contraint, l’IA peut être utilisée pour ces étapes, au lieu d’être réservée à la génération de code.
Revolut présente une amélioration du temps de codage et du « lead time ». Ici, ce dernier désigne le délai entre la prise en charge d’une fonctionnalité et son intégration, prête à être déployée. Il ne mesure donc pas nécessairement le temps jusqu’à sa mise à disposition effective aux clients.
Il faut également distinguer observation et attribution. Les courbes présentées accompagnent plusieurs changements d’outils et de pratiques ; elles n’isolent pas l’effet propre de l’auto-hébergement. La présentation orale et la diapositive donnent par ailleurs des pourcentages différents pour le lead time. Retenir une accélération rapportée, sans transformer un pourcentage en promesse reproductible, restitue mieux ce que cette conférence établit.
Ce que votre entreprise peut reprendre de ce cas
Le premier enseignement de Revolut est une question de répartition : quel modèle faut-il utiliser par défaut, et pour quelles tâches faut-il payer une solution différente ? Cette décision peut se tester bien avant d’envisager une infrastructure GPU dédiée.
Choisissez un usage de développement précis, par exemple la préparation de tests sur un dépôt autorisé. Comparez les solutions sur les mêmes tâches : résultat accepté, erreurs, temps de relecture, délai de réponse et coût complet. Une économie par token ne suffit pas si le temps humain nécessaire augmente. À l’inverse, un outil plus accessible peut devenir utile sur des étapes jusque-là négligées.
Si l’auto-hébergement devient pertinent, examinez aussi les conditions du modèle retenu. « Poids ouverts » ne signifie pas que toutes les versions partagent la même licence : les poids de GLM 5.3 disposent de conditions spécifiques. Le choix juridique et le choix d’exploitation font partie du projet.
Chez SAY Digital, nous retenons de Revolut cette démarche : partir du travail réellement accompli, mesurer le coût et la qualité, puis décider de l’architecture. Pour votre équipe, le bon point de départ est un usage à comparer, pas une commande de GPU. Échangeons sur le premier usage que vous souhaitez évaluer.