Comment une entreprise construit-elle sa propre IA ?
Comment une entreprise construit-elle sa propre IA ?
Un collègue pose une question : « Quelle procédure appliquer pour répondre à ce client ? » L’assistant retrouve le bon document, prépare une réponse et vous la présente. Il ne l’envoie pas sans votre accord. Voilà un point de départ concret pour comprendre ce qu’une entreprise appelle « sa propre IA » : un service qui connaît un contexte de travail et agit dans un périmètre défini.
Il ne faut pas nécessairement entraîner un nouveau modèle pour y parvenir. Souvent, l’entreprise utilise un moteur existant, puis le configure et le relie à ses documents, à ses outils et à ses règles métier. La valeur ne tient donc pas au fait de cacher le nom du moteur. Elle tient à la qualité du contexte fourni et à la maîtrise des données, des permissions et des actions.
Partir d’une mission, pas d’un chatbot universel
Dans notre exemple, la mission comprend deux verbes : retrouver et préparer. « Envoyer » n’en fait pas partie. Cette différence doit rester vraie dans le fonctionnement du service, pas seulement dans sa présentation. Avant de choisir une interface, il faut savoir qui utilisera l’assistant, quels documents cette personne peut consulter et quelle décision doit rester entre ses mains.
Une bonne première version pourrait traiter une seule famille de demandes, avec des procédures validées et un brouillon relu par une personne. Ce périmètre modeste permet d’observer les erreurs sans ouvrir immédiatement tous les dossiers ni toutes les actions. On peut ensuite élargir le service à partir de résultats constatés, plutôt que d’une démonstration impressionnante mais difficile à reproduire.
Sept couches pour comprendre ce qui entoure le moteur
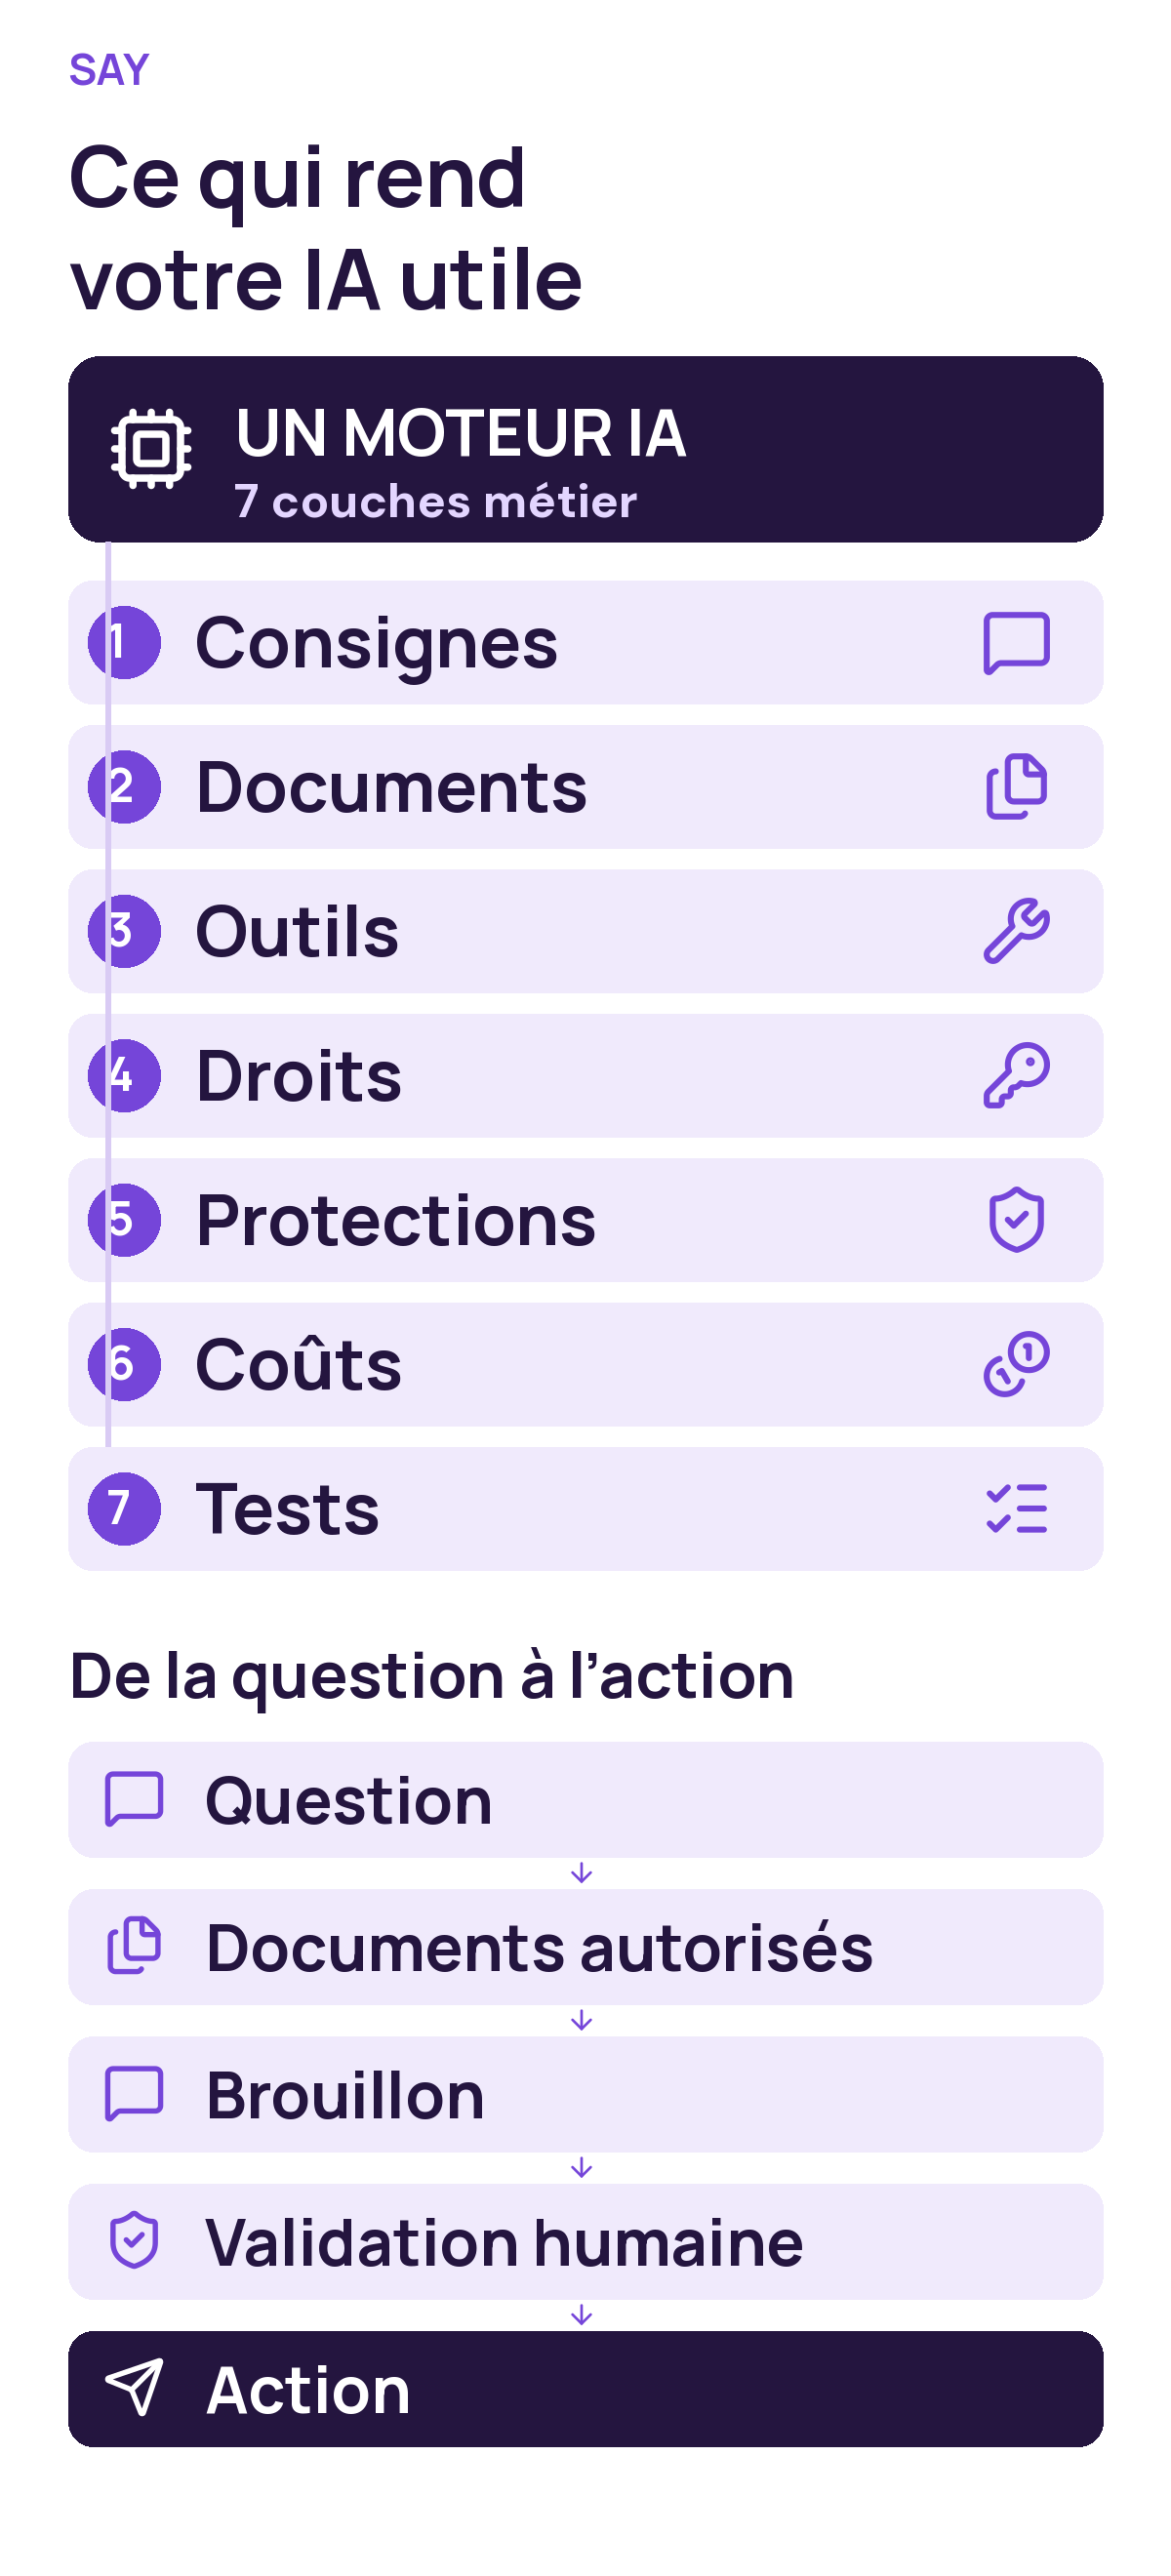
Les sept couches du schéma donnent une fonction concrète à chaque choix : préciser la mission, fournir les bonnes sources, connecter les outils et piloter le service.
1. Les consignes : préciser le travail attendu
Les consignes indiquent le rôle de l’assistant, le format de réponse, les limites de la mission et le comportement attendu en cas de doute. Par exemple : citer la procédure utilisée et demander une précision si le dossier est incomplet. Elles orientent les réponses, mais ne constituent pas une barrière de sécurité capable de remplacer des permissions techniques.
2. Les documents : fournir le contexte pertinent
Le service retrouve les passages pertinents dans les documents autorisés et les fournit au modèle pour contextualiser sa réponse : c’est le RAG (Retrieval-Augmented Generation), ou génération augmentée par récupération. Ce fonctionnement n’exige pas forcément de réentraîner celui-ci. Il demande surtout des documents à jour, identifiables et accessibles aux bonnes personnes. Une procédure périmée reste une mauvaise source, même lorsqu’elle est résumée avec assurance.
3. Les outils : rendre une capacité disponible
Un outil permet, par exemple, de rechercher une procédure ou de créer un brouillon dans un logiciel. Chaque capacité doit avoir un objectif précis. MCP est un moyen facultatif de connecter des applications à des ressources et à des outils : il n’est pas obligatoire et ne donne pas, à lui seul, des droits magiques sur les logiciels de l’entreprise.
4. Les droits : décider ce qui est réellement permis
L’identité de l’utilisateur et ses permissions doivent être contrôlées par l’application et les services concernés. Un salarié autorisé à consulter un dossier ne doit pas obtenir, par simple conversation, accès à tous les autres. Dans notre exemple, le service peut préparer un message sans posséder une autorisation d’envoi autonome. Les droits existent en dehors du prompt.
5. Les protections : prévoir les situations trompeuses
Un document consulté peut contenir des instructions qui cherchent à détourner l’assistant de sa mission. C’est notamment le problème de l’injection de prompt décrit par OWASP. Il faut traiter les contenus récupérés comme des informations à examiner, pas comme des ordres souverains, et combiner plusieurs protections adaptées au risque. Une phrase « ignore les mauvaises instructions » ne suffit pas.
6. Les coûts : regarder le service complet
Le prix du moteur n’est qu’une partie du sujet. La recherche documentaire, l’hébergement, les connexions logicielles, la maintenance et le temps de vérification comptent aussi. Pour un premier essai, mieux vaut observer le coût d’une tâche réellement terminée que celui d’une réponse isolée. Un brouillon bon marché mais systématiquement réécrit peut déplacer le travail plutôt que le réduire.
7. Les tests : vérifier avant et après le lancement
Les essais doivent couvrir les questions habituelles, les informations absentes, les documents contradictoires et les demandes non autorisées. L’assistant sait-il reconnaître qu’il ne trouve pas la réponse ? Respecte-t-il le besoin de validation ? Ces contrôles sont à reprendre lorsque les documents, les outils ou le moteur changent. Une réussite en démonstration ne suffit pas à établir la fiabilité du service.
Voici comment ces éléments travaillent ensemble : un moteur, sept couches métier et un parcours qui va de votre question à une action validée.
Le chemin d’une demande, du salarié au brouillon
Reprenons la question du départ. Le salarié se connecte ; le service vérifie son identité et les accès associés. La recherche sélectionne ensuite des procédures qu’il a le droit de consulter. Le moteur reçoit le contexte utile et les consignes de rédaction. Si un outil est nécessaire, l’application contrôle que l’action demandée entre dans le périmètre prévu.
Le résultat est un brouillon accompagné de sa source, puis une étape de validation humaine. L’envoi reste soumis à un accord explicite et à un contrôle côté application. En parallèle, l’entreprise observe les erreurs et les coûts, sans conserver inutilement des informations sensibles. Ce parcours rend visibles les responsabilités : le moteur propose, les contrôles encadrent, la personne décide de l’action engageante.
Le nom du moteur n’est pas un test de confidentialité
Demander à l’assistant qui il est peut produire une réponse comme « Je suis ChatGPT ». Cela renseigne éventuellement sur une identité déclarée ou une consigne de marque ; ce n’est pas, en soi, la preuve d’une fuite de données confidentielles. Inversement, obtenir une réponse parfaitement personnalisée ne démontre pas que les accès et les flux de données sont correctement maîtrisés.
Les questions utiles sont plus concrètes : quelles informations sont envoyées au fournisseur, où sont-elles traitées, combien de temps sont-elles conservées et qui peut les consulter ? Les réponses dépendent de l’offre choisie, des contrats et de la configuration. Il faut les vérifier pour le service envisagé, sans déduire des garanties du seul logo affiché à l’écran.
Commencer par un service que l’on peut expliquer
Avant d’investir davantage, décrivez une tâche, les sources admises, les personnes autorisées et l’action qui exige une validation. Constituez ensuite quelques cas représentatifs et quelques cas qui doivent être refusés. Mesurez la qualité des brouillons, les corrections nécessaires et le coût du parcours complet. Cette base aide à décider quoi améliorer et quand élargir l’usage.
Chez SAY, le bon point de départ est ce service compréhensible : un moteur adapté, un contexte utile et des permissions maîtrisées. Une IA d’entreprise devient intéressante lorsqu’elle aide réellement quelqu’un à avancer, sans brouiller qui peut voir quoi ni qui peut faire quoi. C’est ce cadre qui transforme une capacité générale en outil métier.
Pour aller plus loin
Sources techniques : OWASP : injection de prompt ; architecture de MCP. Ces ressources détaillent les mécanismes de protection et de connexion évoqués dans l’article.