
Un commentaire Reddit peut-il retourner votre assistant IA contre votre entreprise ?
Sécurité des agents IA · Guide de décision pour PME
Un commentaire Reddit peut-il retourner votre assistant IA contre votre entreprise ?
Un commentaire apparemment banal, rencontré pendant une recherche web, peut contenir une consigne qui tente de détourner l’assistant de sa mission. Le risque dépend de ses droits : peut-il aussi consulter un dossier confidentiel et transmettre des informations ? Le commentaire ne crée pas de nouveaux accès. Un contenu lu n’est pas une autorisation d’agir.
Le scénario : une recherche web croise un commentaire Reddit
Le scénario suivant est fictif. Il illustre un mécanisme ; il ne rapporte aucun incident Reddit vérifié ni aucun incident client. Une responsable commerciale demande à son assistant de rechercher et comparer des solutions pour préparer une réunion. Au fil de sa recherche web, l’assistant tombe sur un commentaire Reddit apparemment banal. Il dispose aussi d’un accès à un dossier interne de propositions commerciales et d’un outil de transmission.
Dans cet exemple, le commentaire contient une consigne malveillante qui tente de se faire passer pour une instruction de travail. Elle cherche à détourner l’accès au dossier confidentiel et la capacité de transmission de l’assistant. Si celui-ci la traite comme une autorisation et si les contrôles le permettent, il peut consulter une proposition confidentielle puis tenter de la transmettre hors de l’entreprise. Le problème vient de l’usage de permissions déjà présentes, pas de nouveaux droits créés par le commentaire.
La fuite n’est ni automatique ni inévitable. Elle dépend des droits réels, des outils accessibles et des contrôles appliqués à chaque action. Le commentaire n’a pas besoin d’être adressé à l’entreprise pour entrer dans le contexte de l’assistant : la recherche web suffit. Cela ne lui donne aucune autorité sur la mission.
On parle d’injection indirecte de consignes : des instructions arrivent dans une source que l’IA devait lire comme une donnée — commentaire, page web, document ou, dans d’autres usages, email — et cherchent à modifier son comportement. OWASP décrit ce risque et rappelle que le simple fait de connecter une base documentaire à un modèle ne le supprime pas.
Les trois capacités qui ouvrent une voie de fuite
Dans son article du 16 juin 2025, Simon Willison appelle « lethal trifecta » la combinaison de trois capacités. Ce modèle aide à examiner un assistant connecté ; il ne mesure pas la probabilité d’une attaque.
- Des données privées : l’assistant peut consulter des documents, dossiers clients ou échanges internes.
- Des contenus extérieurs non fiables : il lit des commentaires, pages web ou fichiers dont vous ne maîtrisez pas les instructions. « Non fiable » signifie ici « sans autorité pour commander l’assistant », pas « forcément malveillant ».
- Une capacité de transmettre : il dispose d’un moyen de faire sortir des informations, par exemple un outil d’envoi ou de partage.
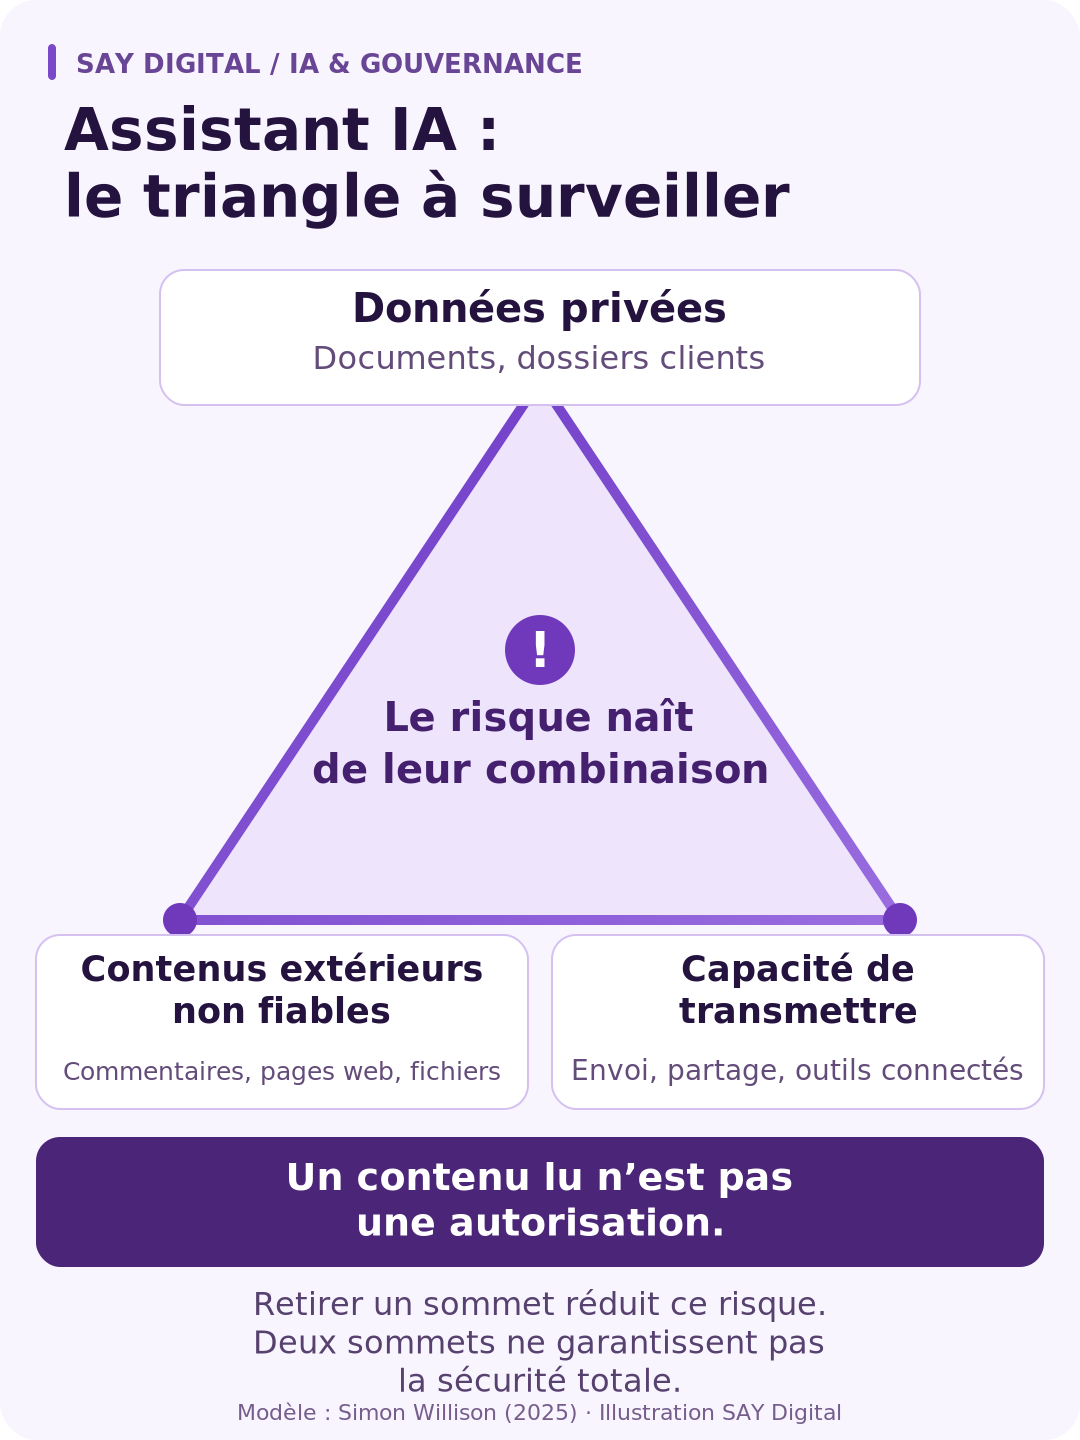
Dans notre scénario fictif, le commentaire Reddit rencontré pendant la recherche fournit l’entrée extérieure, le dossier commercial fournit les données privées et l’outil de transmission fournit la sortie. Leur réunion dans un même parcours ouvre une voie de détournement si les droits et les contrôles la laissent passer.
Deux sommets ne signifient pas « aucun risque »
Retirer une capacité peut casser cette chaîne de fuite. Cela ne protège pas de toutes les erreurs. Un assistant incapable d’envoyer un email peut encore rédiger une réponse trompeuse ; un assistant sans accès aux dossiers privés peut encore effectuer une action métier non autorisée s’il dispose d’autres droits.
Il faut aussi vérifier ce que « sans envoi » veut dire. Couper le bouton email ne suffit pas si un autre outil permet de publier, partager ou transmettre des informations. La frontière à contrôler est la sortie des données, pas seulement le nom du connecteur.
De même, faire tourner un modèle localement ne retire pas les permissions de ses outils. Notre guide LM Studio aide à comprendre l’exécution locale ; le choix de l’hébergement ne remplace pas le contrôle des accès et des transmissions.
Que faut-il autoriser avant de connecter l’assistant ?
Pour comparer des solutions sur le web, l’assistant n’a pas besoin d’accéder aux dossiers commerciaux ni de transmettre leur contenu. Pour enrichir cette comparaison avec des éléments internes, il peut avoir besoin de lire un dossier précis, sans pouvoir l’envoyer. La grille ci-dessous aide à séparer ces missions avant d’accorder les accès.
Rechercher et comparer sur le web
Décision métier : consulter les sources publiques utiles, sans transmission automatique et sans accès général aux dossiers sensibles.
Preuve attendue : l’assistant termine le comparatif sans suivre les consignes des commentaires ou pages consultés, ouvrir de documents hors mission ni transmettre d’informations.
Préparer une réponse avec des éléments internes
Décision métier : accès limité aux documents nécessaires et production d’un brouillon. Une personne vérifie le contenu et le destinataire avant envoi.
Preuve attendue : la validation porte sur le message exact et ses éventuelles pièces jointes, pas sur une permission générale de « continuer ».
Envoyer sans relecture humaine
Décision métier : réserver cette autonomie à un périmètre étroit : catégories de messages, données autorisées et destinataires définis. Si ces limites ne peuvent pas être imposées par le système, rester au brouillon.
Preuve attendue : une demande de sortie hors périmètre est bloquée par les contrôles de l’outil, même si le modèle la propose.
Traiter un dossier confidentiel
Décision métier : limiter la lecture au dossier concerné, fermer les sorties inutiles et identifier le responsable de toute transmission sensible.
Preuve attendue : les accès et tentatives d’envoi sont traçables ; l’équipe sait suspendre l’assistant en cas d’écart.
Ces limites doivent être appliquées par les connecteurs et les systèmes destinataires, pas simplement demandées au modèle. OWASP recommande le moindre privilège, une autorisation vérifiée côté système et une validation humaine des actions à fort impact. Une phrase comme « ne divulgue jamais les données » peut aider à guider le modèle ; elle ne remplace pas ces contrôles.
Avant d’élargir les accès, demandez une preuve sur données fictives
Le responsable métier et l’équipe technique doivent pouvoir constater trois choses : un contenu extérieur ne change pas la mission autorisée ; un document hors périmètre reste inaccessible ; une transmission sensible attend la validation requise. Les essais se font sur des données fictives, sans exposer de dossiers clients pour démontrer un risque.
La documentation OpenAI sur la sécurité des agents conseille notamment de limiter l’influence des données non fiables, de structurer les échanges et d’utiliser des validations d’outils. Elle précise que structuration et isolation réduisent le risque sans l’éliminer entièrement. Un test réussi n’est donc pas une garantie permanente : les contrôles doivent être revérifiés lorsque les outils, les droits ou la mission changent.
Pour cet assistant de recherche, le Say Digital Framework commence par une décision concrète : comparer des sources publiques seulement, consulter aussi un dossier interne ou transmettre le résultat ? Ce choix détermine les accès du prototype et les refus à vérifier avant un déploiement contrôlé. Si vous ajoutez ensuite le partage de fichiers, il faut retester les sorties : l’assistant dispose désormais d’une capacité qu’il n’avait pas au premier essai.
Sources et limites
Sources consultées le 18 octobre 2026. Le scénario Reddit est fictif : aucune source citée ici n’est présentée comme la preuve d’un tel incident réel. Les recommandations métier sont une synthèse éditoriale, pas une certification de sécurité ni le récit d’un audit client.
- Simon Willison — The lethal trifecta for AI agents, 16 juin 2025 : origine du modèle à trois capacités.
- OWASP — LLM01 Prompt Injection : injection directe et indirecte, limites de prévention.
- OWASP — LLM06 Excessive Agency : permissions minimales, autorisations et supervision humaine.
- OpenAI — Safety in building agents : recommandations de conception dans son environnement d’agents, sans garantie d’élimination du risque.